人工智慧音樂情感反應分析 數據建模保護版權指南
「當音符不再只是頻率,而是能被量化的情緒波動時,我們該如何定義創作的邊界?」
人工智慧音樂情感反應分析是透過技術手段,將聽眾對旋律、節奏與音色的感性體驗轉化為可觀測的數據模型。這項技術主要針對音樂作品在引發人類情緒(如喜悅、憂鬱、緊張或平靜)時的生理與心理反應進行建模,藉此優化 AI 生成音樂的感染力。對於音樂創作者而言,這不僅是提升作品品質的工具,更是辨識 AI 抄襲行為、維護原創性與版權權益的重要技術防線。 1. 情感數據建模:將聽眾生理指標與音訊特徵關聯。 2. 生成品質優化:根據情感目標調整 AI 參數。 3. 版權侵權檢測:比對 AI 作品與人類作品的情感特徵圖譜。
什麼是人工智慧音樂情感反應分析?
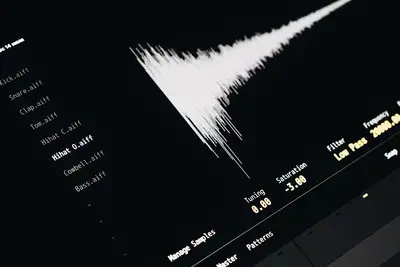
在昏暗的錄音室裡,工程師戴著耳機,專注地觀察螢幕上跳動的波形與情緒曲線,試圖找出某段旋律與聽眾心跳同步的瞬間。人工智慧音樂情感反應分析的核心,在於將抽象的「感覺」轉化為具體的「特徵」。透過分析音高、力度、音色以及節奏的變化,系統可以模擬出音樂在不同情境下可能引發的情緒反應。
這種技術不僅僅是聽音辨位,更深入到音樂情緒辨識技術的層次。透過深度學習,系統能夠學習人類對特定和弦進行或節奏變換的感性回饋,進而判斷一段音樂是否具備某種特定的情感色彩。這讓 AI 不再只是生硬地組合音符,而是學會如何「說故事」,讓生成的音樂能精準擊中聽眾的感性脈點。
如何利用 AI 音樂生成與創作者權益探討?
我坐在靜謐的書房中,指尖輕觸著冰冷的鍵盤,思考著人工智慧音樂情感反應分析如何守護創作者的靈魂。
當我坐在電腦前,試著用 AI 工具生成一段悲傷的鋼琴曲時,我發現技術的便利性往往伴隨著對原創價值的威脅。隨著技術演進,音樂創作版權保護新趨勢已開始將「情感特徵」納入版權爭議的討論範疇。如果 AI 生成的作品在情感結構、情緒起伏與核心旋律特徵上,與人類作曲家的作品高度重合,這是否構成侵權?
這是一個複雜的法律與技術交叉領域。目前,情感分析在音樂製作應用中,正被用來建立一種新型的數位指紋。這種指紋不只包含音頻波形,還包含情感曲線的特徵。當創作者可以證明其作品具有獨特的情感表達邏輯時,這將成為對抗無差別 AI 生成內容的重要武器,保護人類創作中那份不可取代的靈魂。
該如何建立情感數據分析呢?
在實驗室的環境中,研究人員必須嚴謹地執行數據採集與模型訓練流程,以確保分析結果的可靠性。要實現精準的情感分析,通常需要遵循以下嚴謹的程序:
- 數據採集與標註:收集大量包含明確情緒標籤的音樂樣本,並同步紀錄受試者的生理數據(如心率或皮膚電位)。 2. 特徵提取與建模:利用演算法從音訊中提取音高、節奏、音色等特徵,並建立這些特徵與情緒標籤之間的關聯模型。 3. 模型驗證與迭代:將新生成的音樂輸入模型,比對其預測的情感特徵與目標情感是否一致,並根據誤差進行參數調整。
完成上述步驟後,必須進行最後的交叉檢驗,確保模型在面對未知風格的音樂時,依然能保持穩定的情感辨識能力。
AI 音樂對聽眾的感性影響有哪些限制?
在寧靜的聆聽空間裡,聽眾閉上眼睛,任由音樂流淌,試圖感受旋律帶來的深層共鳴。然而,儘管技術不斷進步,AI 音樂對聽眾的感性影響仍存在明顯的技術邊界。目前的分析模型高度依賴於既有的數據集,這意味著它可能難以捕捉到人類文化中極其微妙、甚至具有文化偏差的特殊情感表達。
此外,情感反應分析的倫理考量也是不可忽視的一環。我們必須思考,當 AI 能夠精準操控人類的情緒反應時,這是否會導致聽眾在聽覺體驗上的被動化。目前的技術雖然能模擬情緒,但對於人類情感中那種「不可言說」的複雜性與矛盾感,仍存在著無法完全模擬的侷限性。
情感數據與版權保護的對比
為了更直觀地理解情感分析技術在音樂產業中的角色,我們可以透過下表觀察傳統技術與新興情感技術的差異:
| 特徵維度 | 傳統音頻指紋技術 | AI 情感反應分析技術 |
|---|---|---|
| 核心比對對象 | 波形與頻譜特徵 | 情緒曲線與感性特徵 |
| 主要應用目標 | 偵測音訊重複與盜用 | 評估音樂感染力與情感一致性 |
我曾嘗試用這兩種方式來檢測一段 AI 生成的旋律,發現傳統技術可能無法發現細微的結構模仿,但情感分析卻能察覺到其情緒起伏與原創作品的驚人相似度。
同一主題也稱為AI音樂情緒辨識技術。
同一主題也稱為AI音樂對聽眾的感性影響。
這裡也包含AI音樂生成與創作者權益探討。
這裡也包含音樂情感反應分析的倫理考量。
如何利用情感數據保護音樂版權
相關文章
情感數據的應用邊界在哪裡?
當音符不再只是頻率,而是能被量化的情緒波動時,我們該如何定義創作的邊界?
情感數據的應用邊界,主要體現在模型所能涵蓋的情緒廣度上。現有的分析系統,雖然擅長識別主流、明確的情緒,例如喜悅或憂鬱,但對於那些模糊、多層次、需要特定文化背景才能理解的「當音符」所帶來的細膩感受,卻難以精確捕捉。這就牽涉到數據採集時的選擇性問題。當我們僅用既有的數據集來訓練模型時,系統的判斷邏輯就會被這些數據所限制。因此,要讓 AI 真正理解創作的深度,就必須擴展數據採集的維度,讓它能識別出那些非標準化、極為個人化的情感表達模式。這也是我們在討論「當音符」的定義時,必須面對的技術挑戰。
評論 0