AI音樂聲學設計標準:動態控制決定音樂張力層次感
在構建數位音訊的過程中,理解聲音的本質是所有創作的起點。本文將探討 AI 音樂的音響設計基礎,透過分析聲音的心理屬性與結構,為生成式音樂建立更具表現力的基準。
所謂的 AI 音樂音響設計基礎,核心在於將數學算法轉化為符合人類聽覺感知的聲學特徵。透過對音色、動態與頻譜的精確控制,設計者能確保生成的音軌不僅僅是頻率的組合,而是具備情感共鳴的聽覺體驗。
聲音的心理屬性如何影響 AI 音樂音響設計基礎?
在昏暗的工作室裡,我伸手撥動合成器的旋鈕,試圖捕捉那種能觸動情緒的音樂聲學設計標準。
在工作室的監聽環境中,調整數位參數時常會發現,某些頻率的變動會直接影響聽者的情緒反應。這類現象在 AI 音樂音響設計基礎的建立過程中至關重要,因為算法必須模擬人類對聲音的感官理解。
根據 Seashore 在其著作《音樂心理學》(Psychology of Music)中所提出的觀點,他識別出了四種「聲音的心理屬性」。這些屬性為數位音訊的處理提供了理論支柱,讓設計者能從心理聲學的角度出發,調整合成器的參數。
當我們在處理生成式音訊時,不能僅僅關注頻率的正確性,更要考慮這些心理屬性如何影響聽覺品質。如果忽略了這些屬性,生成的音樂可能會顯得機械化,缺乏自然感。因此,將這些心理學概念轉化為數位模型,是提升音色設計品質的關鍵路徑。
然而,當聽眾的個人文化背景與審美偏好差異極大時,心理屬性的普遍性應用效果將受到限制。
如何進行生成音樂聲學標準的維度分析?
調整控制台上的推桿時,設計者需要考慮不同音色之間的平衡與層次感。在制定生成音樂聲學標準時,必須考慮到聲音在空間與時間維度上的表現,以確保 AI 生成的音軌具備結構化的美感。
生成音樂聲學標準不只是單一的頻率範圍,它包含了對瞬態反應、諧波結構以及音色包絡的全面規範。透過建立這些標準,可以讓不同參數下的 AI 模型在輸出時,保持一致的聽覺品質。
在實際操作中,設計者會針對不同的音樂風格設定不同的基準值。例如,在處理電子合成音色時,動態範圍的設定與在處理管弦樂模擬時的標準會有顯著差異。這種靈活性是確保 AI 音樂能應對多元創作需求的重要環節。
然而,若聲學維度設定過於極端,可能會導致生成音質在物理層面上失去自然感。
AI 音色設計要點的實踐路徑
在數位音訊工作站(DAW)中,從零開始合成一個音色需要精確的參數控制。要實現高品質的 AI 音色設計要點,必須將複雜的聲學物理特性簡化為可控的數位參數,並在生成過程中維持音色的穩定性。
AI 音色設計要點主要可以透過以下三個步驟來實踐:
- 設定基礎頻譜結構:首先定義音色的基頻與諧波比例,這是建立音色辨識度的基礎。 2. 調節動態包絡曲線:透過調整攻擊(Attack)、衰減(Decay)、維持(Sustain)與釋放(Release)參數,賦予聲音生命力。 3. 引入隨機性擾動:在穩定的參數架構中加入微小的隨機變化,以模擬真實樂器的自然不規則性。
完成上述步驟後,最後需要進行音色一致性檢查。我曾在進行音色建模時發現,如果隨機性過高,雖然聲音聽起來自然,但卻會導致音樂風格的崩解。因此,在維持自然感的同時,必須確保音色特徵在整首樂曲中具有連貫性。
- 定義目標音色的心理屬性與頻譜特徵。
- 透過參數化控制進行音色合成與微調。
- 進行動態範圍與瞬態響應的驗證與優化。
數位音樂聲學規範的應用場景
在不同的播放環境中測試音訊輸出時,設計者必須考慮環境聲學對聲音的影響。數位音樂聲學規範的應用,不僅是為了讓音樂好聽,更是為了確保在不同設備上的播放效果都能符合設計初衷。
數位音樂聲學規範涵蓋了從單聲道到環繞聲道的各種轉換邏輯,以及不同採樣率下的音質維持。當 AI 生成音樂時,必須確保輸出的檔案符合標準的動態範圍與頻寬規範,避免在不同播放平台上出現失真或相位問題。
在處理跨平台的音訊輸出時,這類規範尤為重要。例如,針對行動裝置優化的音訊與針對家庭劇院優化的音訊,其頻率對應與動態壓縮邏輯應有所區別。透過嚴格執行這些規範,可以極大化 AI 音樂的傳播力與聽覺一致性。
但若應用環境的硬體播放設備品質極低,嚴格遵守高階聲學規範的實際聽感提升將有限。
結合實例的 AI 音樂音響設計案例分析
在進行跨文化音樂風格的模擬時,設計者常會面臨不同傳統樂器特性的挑戰。透過 AI 音樂音響設計案例分析,我們可以觀察到如何將傳統聲學特性轉化為現代數位參數,並應用於自動化音樂生成。
透過分析現有的數位音樂案例,我們可以發現不同文化背景下的聲學特徵。例如,在某些地區的傳統音樂中,特定的音階與音色組合具有高度的文化辨識度。在進行 AI 模型訓練時,將這些特定的聲學特徵納入參數空間,能讓生成的音樂更具文化深度。
這種案例分析不僅能幫助開發者優化演算法,也能為音樂創作者提供靈感。透過將傳統樂器的物理模型與 AI 的生成能力結合,設計者可以創造出既具有現代感又保留傳統韻味的創新音色。
然而,案例中的特定參數配置僅適用於該特定情境,不一定能直接套用於所有音樂風格。
相關文章
聲音的結構性分析如何輔助 AI 音樂的音響設計?
聲音的結構性分析在構建數位音訊時,提供了一套從物理層面理解聲音組成的框架。設計者需要將聲音的構成要素,如頻譜的密度和諧波的複雜度,轉化為可被算法理解的量化指標。這有助於在構建生成式音樂時,確保音色不僅聽起來悅耳,其內在的聲學結構也是穩固且可預測的。
透過分析聲音的結構,我們可以更精準地控制音色的「材質感」。例如,高頻諧波的豐富程度決定了聲音的明亮度,而低頻的能量分佈則影響了聲音的厚實度。AI 模型在學習聲音時,如果僅依賴聽覺上的標籤,可能會遺漏這些底層的結構細節。因此,將結構分析融入訓練數據,能讓 AI 在生成時,能更細膩地模擬真實樂器的聲學特性,這也是提升音色設計品質的另一條重要路徑。
然而,過度依賴結構性分析可能會導致音樂失去情感上的隨機性與藝術靈魂。
數位音訊流程中,聲音的動態控制扮演什麼角色?
聲音的動態控制在整個數位音訊流程中扮演著決定音樂張力與層次感的關鍵角色。設計者必須確保音量的變化不是隨機的,而是遵循著音樂的敘事邏輯。這要求 AI 模型在生成過程中,必須精確地模擬聲音的起伏變化。
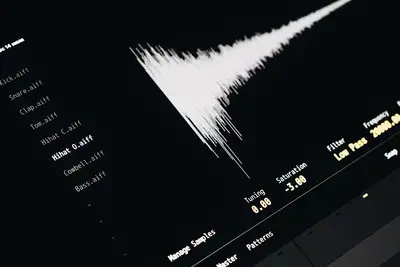
在調整動態包絡曲線時,攻擊時間決定了聲音的「衝擊感」,而釋放時間則影響了聲音的「尾音感」。如果攻擊過於平緩,聲音會顯得缺乏穿透力;反之,如果釋放過於迅速,聲音的餘韻就會被突然切斷。這些參數的協同作用,決定了聽眾在聆聽時所感受到的聽覺體驗的豐富程度。因此,在構建音響設計時,動態的細微調整,比單純的頻率調整更能體現音樂的生命力。
評論 0